Tôi nghiên cứu xử lý ngôn ngữ tự nhiên và học máy: dạy mô hình nơ-ron thực hiện các phép tính thường được biểu diễn bằng chương trình ký hiệu hoặc các bước suy luận tường minh. Nhóm của tôi biên dịch đặc tả hàm bằng ngôn ngữ tự nhiên thành chương trình nơ-ron có thể tái sử dụng (ProgramAsWeights), mô phỏng môi trường máy tính tương tác bằng mô hình tạo sinh (NeuralOS), đồng thời nghiên cứu chuỗi suy nghĩ ngầm (Implicit CoT) và nội hóa suy luận. Chúng tôi cũng nghiên cứu cách sử dụng mô hình ngôn ngữ qua các cuộc hội thoại WildChat và công cụ phân tích WildVis.
Tôi xây dựng các hệ thống mã nguồn mở và demo tương tác để các nhà nghiên cứu khám phá, đánh giá và phát triển tiếp những ý tưởng này. OpenAI và Anthropic đã dùng WildChat để đánh giá độ an toàn của mô hình. Tôi cũng đồng phát triển OpenNMT, bộ công cụ mã nguồn mở cho dịch máy nơ-ron được sử dụng rộng rãi trong nghiên cứu và công nghiệp. Tôi nhận bằng Tiến sĩ Khoa học máy tính tại Harvard University dưới sự hướng dẫn của Alexander Rush và Stuart Shieber, rồi nghiên cứu sau tiến sĩ cùng Yejin Choi tại Allen Institute for AI.
Tôi tin rằng tiền huấn luyện mô hình để biên dịch các tác vụ lặp lại thành chương trình nơ-ron nhỏ, có thể tái sử dụng, thay vì luôn giải lại bài toán từ đầu, là một trong những hướng phát triển hấp dẫn nhất của AI trong tương lai.
Hướng nghiên cứu
ProgramAsWeights (PAW)
Một mô hình lập trình mới: biên dịch đặc tả hàm bằng ngôn ngữ tự nhiên thành chương trình nơ-ron có thể tái sử dụng, thay thế mã ký hiệu cho các hàm mờ. Mục tiêu của chúng tôi là lập trình không cần mã làm trung gian.
Dự án và demo ·Tổng quan nghiên cứu ·Danh sách tài liệuMô hình thế giới nơ-ron (Neural World Models)
Các mô hình tạo sinh học hành vi của môi trường máy tính tương tác như thế nào? NeuralOS mô phỏng toàn bộ hệ điều hành bằng mô hình tạo sinh nơ-ron, tạo ra các thay đổi giao diện để đáp ứng thao tác của người dùng.
Demo tương tác ·Danh sách tài liệuChuỗi suy nghĩ ngầm (Implicit CoT)
Chúng tôi là những người đầu tiên đề xuất suy luận bằng chuỗi suy nghĩ ngầm (Implicit CoT, còn gọi là latent reasoning) vào năm 2023: mô hình ngôn ngữ suy luận qua các trạng thái ẩn liên tục thay vì viết các bước trung gian thành lời. Các phương pháp của chúng tôi gồm chưng cất tri thức và học cách nội hóa suy luận từng bước (Internalized reasoning).
Bài báo năm 2023 ·Bài báo năm 2024 ·Demo tương tác ·Hướng dẫn đọc ·Workshop ICLR 2026Sử dụng mô hình ngôn ngữ trong thực tế
Mọi người sử dụng mô hình ngôn ngữ lớn như thế nào trong thực tế? Chúng tôi thu thập và phân tích hàng triệu cuộc hội thoại thực để nghiên cứu cách sử dụng, độ an toàn của mô hình và các hành vi nảy sinh, đồng thời công bố dữ liệu mở và công cụ phân tích.
WildChat ·AI Observatory ·WildVisBài báo tiêu biểu
Wentao Zhang*, Liliana Hotsko*, Woojeong Kim*, Pengyu Nie, Stuart Shieber, Yuntian Deng.
NeurIPS 2026
Biên dịch đặc tả hàm bằng ngôn ngữ tự nhiên thành chương trình nơ-ron, dùng trọng số mô hình để thực hiện các phép tính của hàm.
Bài báo và dự án Mã nguồn và tài nguyên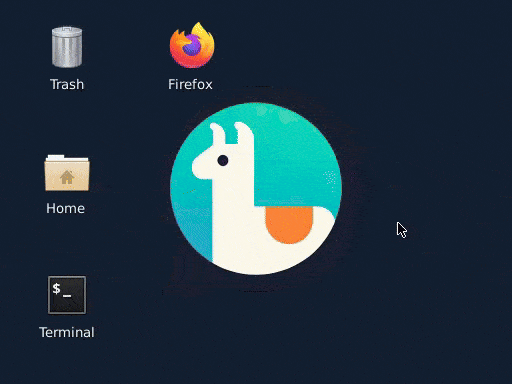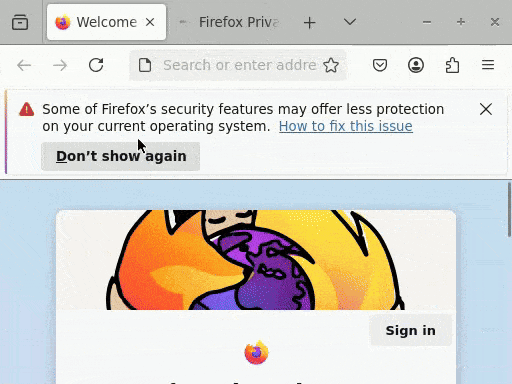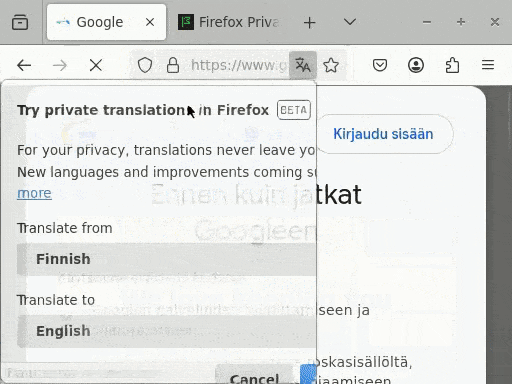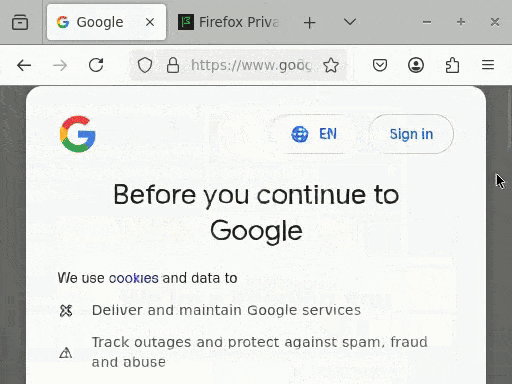
Luke Rivard, Sun Sun, Hongyu Guo, Wenhu Chen, Yuntian Deng.
ICLR 2026
Mô phỏng toàn bộ hệ điều hành bằng mô hình tạo sinh nơ-ron, tạo ra các thay đổi giao diện từ thao tác của người dùng.
Bài báo và dự án Mã nguồn và tài nguyên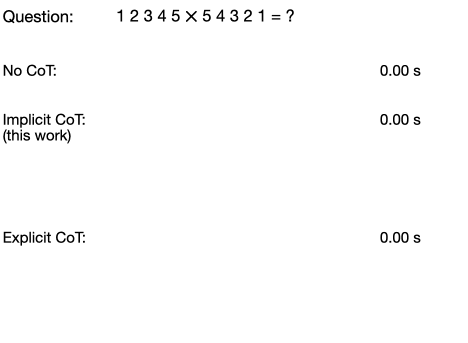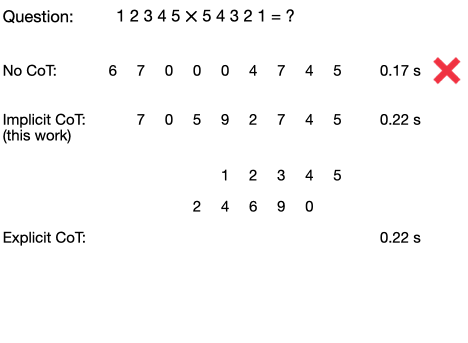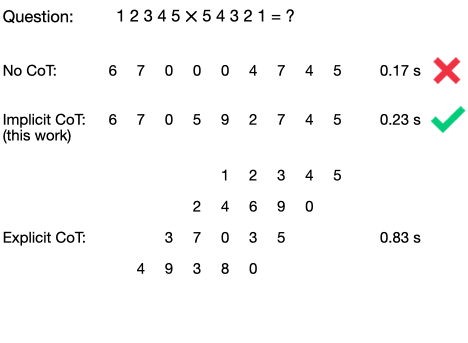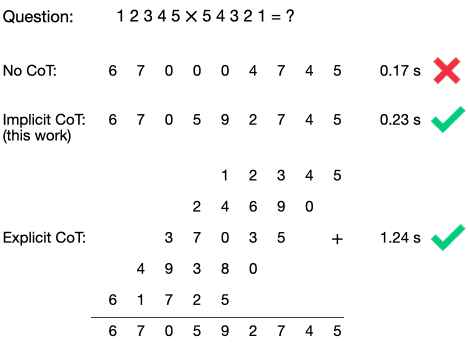
Yuntian Deng, Kiran Prasad, Roland Fernandez, Paul Smolensky, Vishrav Chaudhary, Stuart Shieber.
arXiv 2023
Năm 2023, chúng tôi là những người đầu tiên đề xuất suy luận bằng chuỗi suy nghĩ ngầm qua các trạng thái ẩn liên tục, đồng thời dùng chưng cất tri thức để chuyển suy luận tường minh vào bên trong mô hình.
Bài báo và dự án PDF HTML Mã nguồn và tài nguyên
Yuntian Deng, Yejin Choi, Stuart Shieber.
arXiv 2024
Loại bỏ dần các bước suy luận tường minh trong quá trình huấn luyện để dạy mô hình suy luận bên trong và đưa ra câu trả lời trực tiếp.
Bài báo và dự án PDF HTML Mã nguồn và tài nguyên
Wenting Zhao, Xiang Ren, Jack Hessel, Claire Cardie, Yejin Choi, Yuntian Deng.
ICLR 2024 (Spotlight)
Tập hợp các cuộc hội thoại đa ngôn ngữ, nhiều lượt giữa người dùng thực và ChatGPT để nghiên cứu hành vi người dùng, độ an toàn của mô hình và việc huấn luyện mô hình ngôn ngữ.
Bài báo và dự án PDF Mã nguồn và tài nguyênHướng dẫn nghiên cứu
Hướng dẫn nghiên cứu về mô hình ngôn ngữ và học có cấu trúc trình bày Tree Prompting, mô hình dựa trên năng lượng, cơ chế chú ý xác suất, giải mã có cấu trúc, đánh giá văn bản dài, kết xuất hình ảnh thông qua học máy và huấn luyện tương tác. Các hướng dẫn tập hợp bài báo gốc, ví dụ phương pháp, nghiên cứu liên quan và trích dẫn.
Image-to-Markup và IM2LATEX-100K trình bày nghiên cứu của chúng tôi trong giai đoạn 2016–2017 về chuyển đổi hình ảnh thành LaTeX, kèm bộ dữ liệu, mã nguồn và demo tương tác.
Tham gia nhóm
Nếu muốn tham gia nhóm của tôi, hãy bắt đầu bằng việc đọc ProgramAsWeights, NeuralOS và nghiên cứu về chuỗi suy nghĩ ngầm của chúng tôi (Implicit CoT năm 2023; nội hóa từng bước năm 2024). Trong thư, hãy trình bày ngắn gọn hướng nghiên cứu bạn quan tâm. Do số lượng thư lớn, tôi không thể trả lời các thư không đề cập đến một chủ đề nghiên cứu cụ thể.