मैं प्राकृतिक भाषा प्रसंस्करण और मशीन लर्निंग में शोध करता हूँ: न्यूरल मॉडल उन गणनाओं को कैसे सीखें जिन्हें आम तौर पर प्रतीकात्मक प्रोग्राम या तर्क के स्पष्ट चरणों के ज़रिए व्यक्त किया जाता है। मेरा समूह प्राकृतिक भाषा में दिए गए फ़ंक्शन के विवरण को दोबारा इस्तेमाल किए जा सकने वाले न्यूरल प्रोग्राम में संकलित करता है (ProgramAsWeights), जनरेटिव मॉडल से इंटरैक्टिव कंप्यूटिंग परिवेशों का अनुकरण करता है (NeuralOS), और अंतर्निहित विचार-श्रृंखला (Implicit CoT) तथा तर्क को मॉडल के भीतर समाहित करने पर काम करता है। हम WildChat की बातचीत और WildVis के विश्लेषण टूल से यह भी अध्ययन करते हैं कि लोग भाषा मॉडल का उपयोग कैसे करते हैं।
मैं ओपन-सोर्स सिस्टम और इंटरैक्टिव डेमो बनाता हूँ, ताकि शोधकर्ता इन विचारों को आज़मा सकें, उनका मूल्यांकन कर सकें और उन्हें आगे बढ़ा सकें। OpenAI और Anthropic ने मॉडल सुरक्षा के मूल्यांकन में WildChat का उपयोग किया है। मैं न्यूरल मशीन अनुवाद के ओपन-सोर्स टूलकिट OpenNMT का सह-विकासकर्ता भी हूँ, जिसका शोध और उद्योग में व्यापक उपयोग होता है। मैंने हार्वर्ड विश्वविद्यालय से Alexander Rush और Stuart Shieber के मार्गदर्शन में कंप्यूटर विज्ञान में पीएचडी की। इसके बाद Allen Institute for AI में Yejin Choi के साथ पोस्टडॉक्टरल शोध किया।
मेरा मानना है कि हर बार समस्या को नए सिरे से हल करने के बजाय, प्रीट्रेनिंग के ज़रिए मॉडल को दोहराए जाने वाले कामों को छोटे, पुनः उपयोग योग्य न्यूरल प्रोग्राम में संकलित करना सिखाना AI के भविष्य की सबसे रोमांचक दिशाओं में से एक है।
शोध के क्षेत्र
ProgramAsWeights (PAW)
प्रोग्रामिंग का एक नया तरीका: प्राकृतिक भाषा में दिए गए फ़ंक्शन के विवरण को पुनः उपयोग योग्य न्यूरल प्रोग्राम में संकलित करना, ताकि फ़ज़ी फ़ंक्शन के लिए प्रतीकात्मक कोड की जगह न्यूरल प्रोग्राम काम करें। हमारा लक्ष्य कोड को मध्यस्थ बनाए बिना प्रोग्रामिंग करना है।
परियोजना और डेमो ·शोध परिचय ·पठन सूचीन्यूरल वर्ल्ड मॉडल (Neural World Models)
जनरेटिव मॉडल इंटरैक्टिव कंप्यूटिंग परिवेशों का व्यवहार कैसे सीखते हैं? NeuralOS न्यूरल जनरेटिव मॉडल से पूरे ऑपरेटिंग सिस्टम का अनुकरण करता है और उपयोगकर्ता की गतिविधियों के जवाब में इंटरफ़ेस में बदलाव उत्पन्न करता है।
इंटरैक्टिव डेमो ·पठन सूचीअंतर्निहित विचार-श्रृंखला (Implicit CoT)
हमने 2023 में पहली बार अंतर्निहित विचार-श्रृंखला से तर्क करने (Implicit CoT, जिसे latent reasoning भी कहते हैं) का प्रस्ताव रखा: भाषा मॉडल बीच के चरणों को शब्दों में लिखने के बजाय सतत hidden states के ज़रिए तर्क करते हैं। हमारी विधियों में नॉलेज डिस्टिलेशन और तर्क को चरण-दर-चरण मॉडल के भीतर समाहित करना सिखाना (Internalized reasoning) शामिल हैं।
2023 का शोधपत्र ·2024 का शोधपत्र ·इंटरैक्टिव डेमो ·शोधपत्रों की मार्गदर्शिका ·ICLR 2026 कार्यशालावास्तविक दुनिया में भाषा मॉडल का उपयोग
लोग बड़े भाषा मॉडल का उपयोग कैसे करते हैं? हम उपयोग के तरीकों, मॉडल सुरक्षा और उभरते व्यवहारों का अध्ययन करने के लिए लाखों वास्तविक बातचीत एकत्र करके उनका विश्लेषण करते हैं। डेटा और विश्लेषण टूल खुले रूप में उपलब्ध कराते हैं।
WildChat ·AI Observatory ·WildVisचुनिंदा शोधपत्र
Wentao Zhang*, Liliana Hotsko*, Woojeong Kim*, Pengyu Nie, Stuart Shieber, Yuntian Deng.
NeurIPS 2026
प्राकृतिक भाषा में दिए गए फ़ंक्शन के विवरण को न्यूरल प्रोग्राम में संकलित करते हैं, जो मॉडल के वज़न के ज़रिए फ़ंक्शन की गणनाएँ करते हैं।
शोधपत्र और परियोजना कोड और संसाधन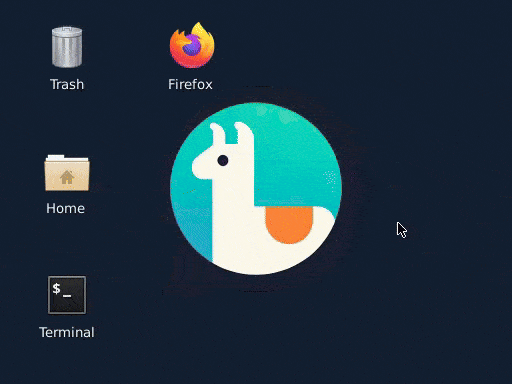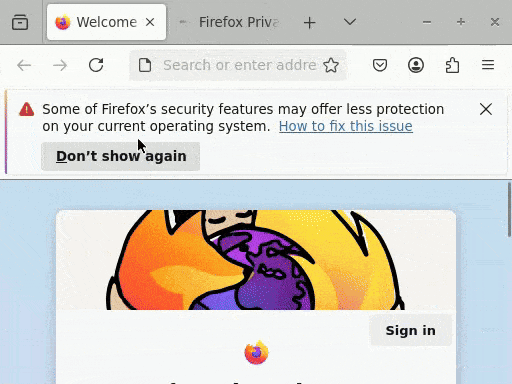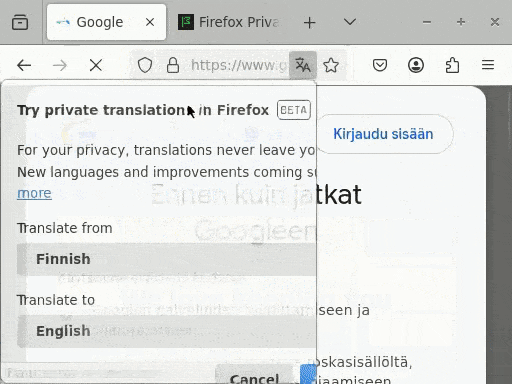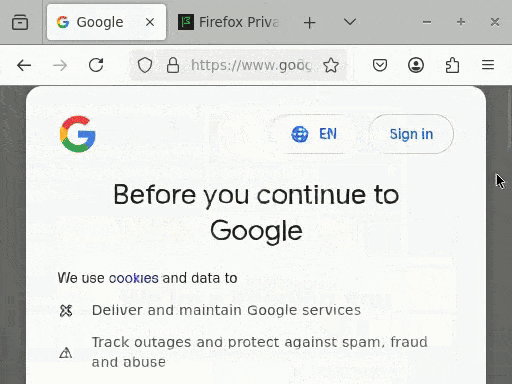
Luke Rivard, Sun Sun, Hongyu Guo, Wenhu Chen, Yuntian Deng.
ICLR 2026
न्यूरल जनरेटिव मॉडल से पूरे ऑपरेटिंग सिस्टम का अनुकरण करते हैं और उपयोगकर्ता की गतिविधियों के आधार पर इंटरफ़ेस में बदलाव उत्पन्न करते हैं।
शोधपत्र और परियोजना कोड और संसाधन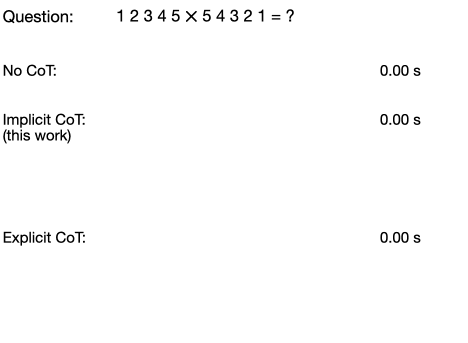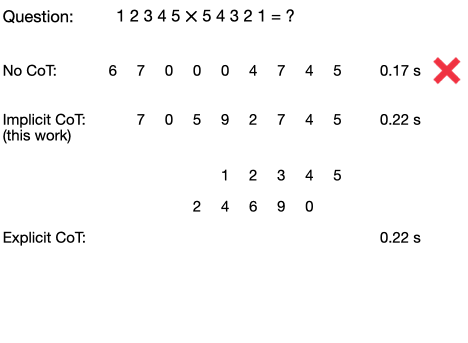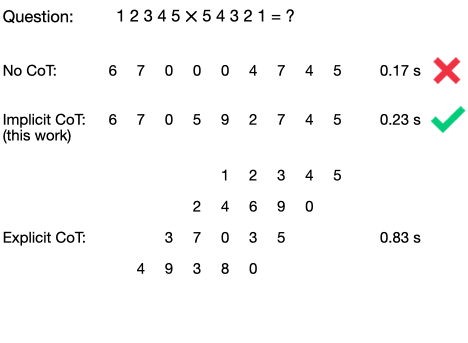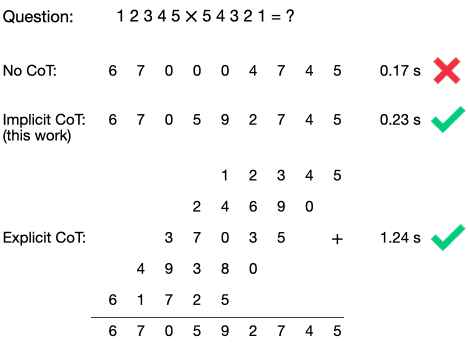
Yuntian Deng, Kiran Prasad, Roland Fernandez, Paul Smolensky, Vishrav Chaudhary, Stuart Shieber.
arXiv 2023
हमने 2023 में पहली बार सतत hidden states के ज़रिए अंतर्निहित विचार-श्रृंखला से तर्क करने का प्रस्ताव रखा और नॉलेज डिस्टिलेशन से स्पष्ट तर्क प्रक्रिया को मॉडल के भीतर स्थानांतरित किया।
शोधपत्र और परियोजना PDF HTML कोड और संसाधन
Yuntian Deng, Yejin Choi, Stuart Shieber.
arXiv 2024
प्रशिक्षण के दौरान तर्क के स्पष्ट चरणों को धीरे-धीरे हटाकर मॉडल को भीतर ही तर्क करना और सीधे उत्तर देना सिखाते हैं।
शोधपत्र और परियोजना PDF HTML कोड और संसाधन
Wenting Zhao, Xiang Ren, Jack Hessel, Claire Cardie, Yejin Choi, Yuntian Deng.
ICLR 2024 (Spotlight)
वास्तविक उपयोगकर्ताओं और ChatGPT के बीच कई भाषाओं में हुई बहु-चरणीय बातचीत एकत्र करते हैं, ताकि उपयोगकर्ता व्यवहार, मॉडल सुरक्षा और भाषा मॉडल के प्रशिक्षण का अध्ययन किया जा सके।
शोधपत्र और परियोजना PDF कोड और संसाधनशोध मार्गदर्शिकाएँ
भाषा मॉडल और संरचित अधिगम की शोध मार्गदर्शिकाएँ Tree Prompting, ऊर्जा-आधारित मॉडल, प्रायिकतात्मक अटेंशन, संरचित डिकोडिंग, लंबे पाठ के मूल्यांकन, सीखकर रेंडरिंग करने और इंटरैक्टिव प्रशिक्षण को समझाती हैं। इनमें मूल शोधपत्र, विधियों के उदाहरण, संबंधित शोध और उद्धरण विवरण दिए गए हैं।
Image-to-Markup और IM2LATEX-100K में चित्रों को LaTeX में बदलने पर हमारा 2016–2017 का शोध, डेटासेट, कोड और इंटरैक्टिव डेमो मिलेंगे।
समूह से जुड़ें
मेरे समूह से जुड़ने में रुचि है तो पहले ProgramAsWeights, NeuralOS और अंतर्निहित विचार-श्रृंखला पर हमारा शोध पढ़ें (2023 का Implicit CoT शोधपत्र; 2024 का चरण-दर-चरण आंतरिकीकरण शोधपत्र)। अपने संदेश में संक्षेप में बताएँ कि किस शोध दिशा में आपकी रुचि है। बड़ी संख्या में ईमेल मिलने के कारण मैं उन संदेशों का उत्तर नहीं दे सकता जिनमें किसी स्पष्ट शोध विषय का ज़िक्र नहीं है।